ローカライズは、ゲームを別の言語や地域の人が遊べるように、文章・画像・音声などを作り替える工程です。翻訳そのものはプロダクション(本制作)の後半、文章がほぼ固まってから行いますが、どの言語にも対応できる作りにしておく「国際化」は、開発の最初から始めます。後から対応すると、画面の作り直しや文字列の洗い出しに大きな手間がかかるからです(工程の全体は「ゲーム開発の全工程マップ」)。
本記事では、国際化とローカライズの違い、最初からやっておくこと、対応する言語の選び方、翻訳の発注、LQA(実機での翻訳チェック)、Steam のストアページでの対応言語の扱いまでを、個人〜少人数の開発を基準にまとめます。Steam の規則と数値、エンジンの仕様は、2026年10月4日に公式の資料で確認したものです。
 夕宮たいだ
ふぁ……みんな〜、今日はローカライズの話だよぉ。翻訳は最後でいいや、って思ってると、あとで画面を作り直すことになるんだぁ。最初にやっておくことから整理していこ〜。
ローカライズとは
ひとことで:ゲームを別の言語・地域の人が自然に遊べるように作り替える工程で、その準備にあたる「国際化」と組で進めます。
W3C(Web の標準を定める団体)の解説では、ローカライズ(localization)は「製品やコンテンツを、特定の市場(ロケール)の言語や文化などの要件に合わせて作り替えること」、国際化(internationalization)は「文化・地域・言語の違う相手へのローカライズを容易にする設計と開発」とされています(Localization vs. Internationalization)。略して l10n・i18n と書くのは、最初と最後の文字の間に10文字・18文字あるからです。
| 国際化(i18n) | ローカライズ(l10n) | |
|---|---|---|
| ひとことで | どの言語にも対応できる作りにする | 特定の言語・地域に合わせて作り替える |
| 主な作業 | 文字列をコードの外に出す、フォントと文字数の伸びに耐える画面、日付や数字の書き方の切り替え | 翻訳、画像や音声の差し替え、用語の統一、実機での確認 |
| いつ | 開発の最初から | 文章がほぼ固まってから、節目ごとに |
| 主に担う人 | プログラマー・UI の担当 | 翻訳者・校正者・テスター |
ローカライズの対象は文章だけではありません。画像の中の文字、音声(吹き替えか字幕か)、ストアページ、地域ごとの文化への配慮まで含みます。目的は「翻訳されていること」ではなく、その言語の人が引っかからずに遊べることです。
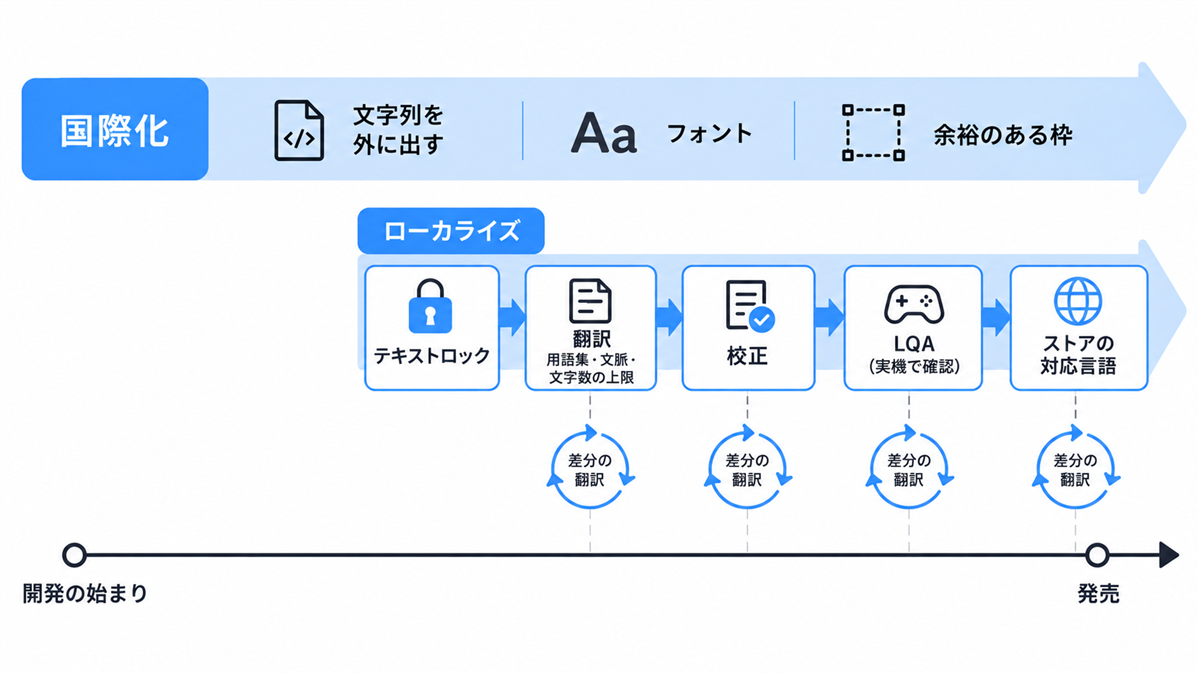
最初からやっておく国際化
ひとことで:文字列・語順・文字数・フォント・画像の文字を、言語を足しても作り直さなくて済む形にしておきます。
文字列をコードの外に出す
画面に出る文章はコードに直接書かず、キー(文章の名前)と言語ごとの訳文を並べた表(翻訳ファイル)に入れて、実行時にキーから引きます。Godot は CSV と gettext の PO 形式の翻訳ファイルを読み込めます(Importing translations)。Unity には Localization パッケージ(文字列と素材の切り替え、疑似ローカライズ、XLIFF や CSV との読み書き)があり(Localization package)、Unreal Engine には文章の収集・書き出し・取り込み・コンパイルを行う Localization Dashboard があります(Localization Tools)。
key,ja,en
ui_start,はじめる,Start
msg_item_get,{name}は{item}を手に入れた,{name} got {item}.
語順・変数・複数形
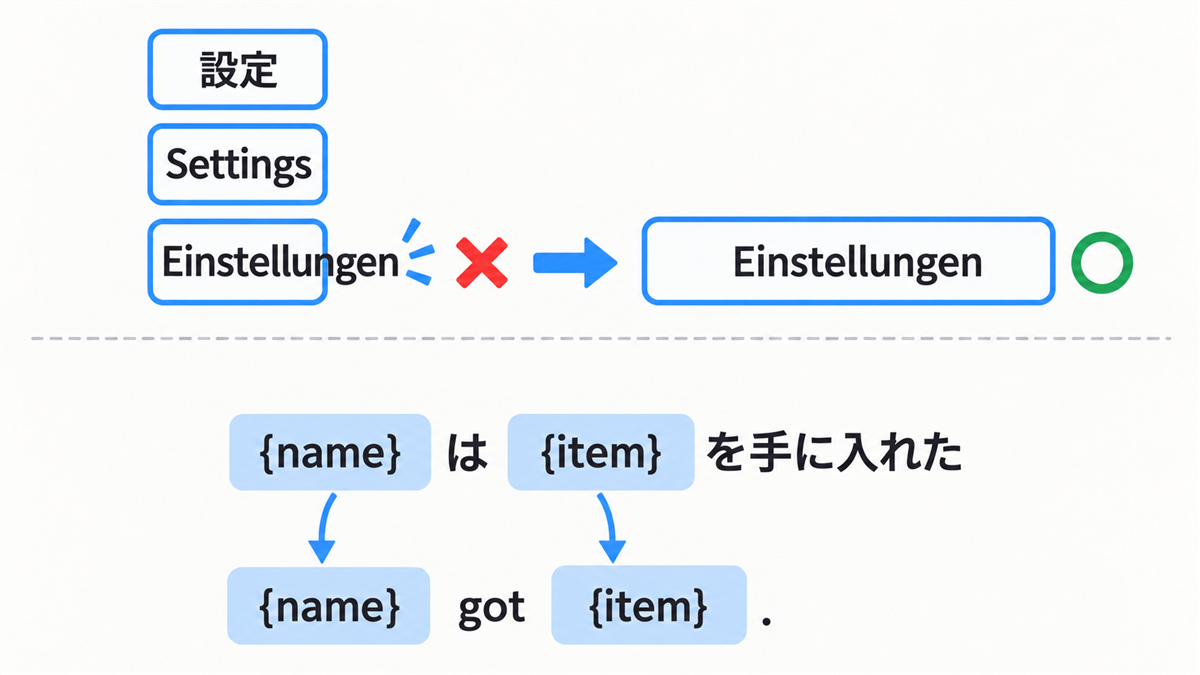
文章を部品に分けてつなぐ作り方(「{name}」+「は」+「{item}」+「を手に入れた」)は避けます。語順は言語によって違うので、1つの文として翻訳者に渡し、{name} のような名前付きの目印で変数の位置を訳文の中で動かせるようにします。Godot の公式ドキュメントも、名前付きの目印なら位置や順番を変えられ、翻訳者にとって文脈も増えると説明しています(Internationalizing games)。
数によって形が変わる「複数形」も言語ごとに違います。Unicode の CLDR(言語ごとの書き方のデータ集)では、日本語は数による区別がなく、英語は「1」と「それ以外」の2種類、ロシア語・ウクライナ語・ポーランド語は4種類、アラビア語は6種類に分けます(Language Plural Rules)。英語の card/cards の出し分けだけで済ませず、エンジンの複数形の仕組み(Godot の tr_n() など)を使います。
 夕宮たいだ
複数形が4種類とか6種類とか……むずかしいねぇ。日本語で作ってると気づかないから、最初から仕組みに乗せておくと安心なんだぁ。
文字数の伸びと画面
訳文は原文より長くなることがよくあります。W3C の解説が紹介する IBM の目安では、英語からヨーロッパの言語に訳すとき、10文字以下の短い文字列は平均で2〜3倍の長さになります(Text size in translation)。ボタンや見出しのような短い言葉ほど、言語による差が大きくなります。
- ボタンや枠に余裕を持たせ、はみ出すときの動き(折り返す・縮める・省略する)を決めておく
- 行の折り返しの決まり(日本語や中国語で行頭に句読点を置かない禁則処理、英語で単語の途中で折らない、など)を確かめる
- 疑似ローカライズ(訳文の代わりに、長く引き延ばして記号を混ぜた文字列を表示するテスト)で、翻訳の前にはみ出しや未対応の文字列を見つける。Godot には、文字列を長くしたりアクセント付きの文字に置き換えたりする機能があります(Pseudolocalization)
フォント
言語を足すときに事故が多いのがフォントです。フォントに無い文字は、豆腐(□)と呼ばれる四角や空白で表示されます。
- 文字の不足:使う言語の文字がフォントに入っているか。筆者の麻雀ゲームでは、ウクライナ語の і ї є ґ が同梱のフォントに入っていませんでした
- 字形の違い:日本語と中国語では、同じ文字コードの漢字でも好まれる字形が違うことがあります。Noto Sans CJK も、日本語(JP)・簡体字(SC)・繁体字(TC・HK)・韓国語(KR)の版を分けて用意しています(Noto CJK)。筆者の麻雀ゲームでは、言語ごとに主フォントを切り替えています
- ライセンス:ゲームに同梱してよいフォントか。Windows に入っているフォントは同梱できない、など(詳しくは「ゲーム開発の権利と規約」)
画像・音声・書き方の違い
- 画像の中の文字:ロゴや説明図に文字を焼き込むと、言語ごとに画像を作り直すことになります。文字は画像と分けて重ねるか、言語ごとの差し替えを前提にします
- 音声:吹き替え(フル音声)にするか、原語の音声に字幕を付けるかで、費用と作業が大きく変わります
- 日付・数字:日付は 2026/10/04(日本)・10/04/2026(米国)・04.10.2026(ドイツ)のように並びが違い、数字の区切りも 1,234.5(英語)と 1.234,5(ドイツ語)のように入れ替わることがあります。自分で組み立てず、エンジンや OS の地域設定の仕組みを使います
- 右から左に書く言語:アラビア語やヘブライ語は右から左に書き、画面の配置も左右が逆になります。Godot はこうした言語で、左右の配置の反転や文字の揃えの入れ替えを自動で行います(Internationalizing games)
どの言語に対応するか
ひとことで:遊ぶ人の多さだけでなく、作品との相性・翻訳の量・発売後も直し続けられるかで選びます。
Steam で遊ぶ人の言語は、Steam ハードウェア&ソフトウェア調査(参加は任意・匿名の月ごとの調査)で公開されています。2026年9月の調査の上位は次のとおりです(Steam Hardware & Software Survey)。
| 言語 | 2026年9月の割合 |
|---|---|
| 英語 | 34.20% |
| 簡体字中国語 | 31.39% |
| ロシア語 | 9.05% |
| スペイン語(スペイン) | 4.08% |
| ポルトガル語(ブラジル) | 3.70% |
| ドイツ語 | 2.48% |
| 日本語 | 2.41% |
| フランス語 | 2.08% |
| ポーランド語 | 1.49% |
| 韓国語 | 1.37% |
| 繁体字中国語 | 1.27% |
この割合は月ごとに大きく動きます。2026年9月は、簡体字中国語が前月より7.42ポイント増えました。「英語が何割」と決めつけず、調べた月を添えて、何か月か分を見比べます。日本の個人開発なら、日本語に加えて、まず英語、次に簡体字中国語を検討すると考えやすくなります(2026年9月の調査では、この2言語で合わせて65.59%)。言語を選ぶときは、次の観点も合わせて見ます。
- 作品との相性:文章の多いノベルゲームは翻訳の量と費用が大きく、操作で遊ぶアクションやパズルは少ない。類似作の対応言語や、どの言語のレビューが多いかも参考になる
- 翻訳の量と費用:文字数(単語数)と言語の数のかけ算で増える。声も訳すならさらに増える
- 直し続けられるか:発売後の更新や修正のたびに、全言語の訳を足す必要がある。問い合わせやレビューに、その言語で応えられるか
- 技術の対応:その言語のフォント、右から左の表示、複数形
Steam の公式の表では、ゲームの対応言語として選べるのは103言語で、そのうち Steam 本体・ストア・コミュニティまで翻訳されている(Full Platform Support)のは31言語です。アラビア語はゲームの言語として使えますが、Steam 本体の表示はアラビア語に翻訳されていません(Languages Supported on Steam)。
 夕宮たいだ
ほえ〜、簡体字中国語が1か月で7ポイントも動くんだぁ。数字を使うときは、調べた月を必ず書いておこうねぇ。
翻訳を発注する
ひとことで:原文を確定させ、用語集・文脈・文字数の上限・画面の写真をそろえて渡すほど、訳の質が上がり、直しが減ります。
翻訳に出す前に、原文を確定させる時点を決めます。この時点をテキストロック(ストリングロック)と呼び、運営型のゲームでは α と β の間に置く例があります(Gridly)。ロックした後に原文を変えると、全言語の訳を直すことになります。
| 渡すもの | 中身 | なぜ必要か |
|---|---|---|
| 翻訳ファイル | キー・原文・訳文に加え、話し手・表示する場所・文字数の上限・メモの列 | 文脈と制約が1行ごとにわかる |
| 用語集 | 固有名詞・ゲーム用語・訳さない語と、その訳 | 同じ言葉の訳がぶれない |
| スタイルガイド | 全体の口調、キャラごとの話し方、呼び方 | キャラの個性が言語ごとに崩れない |
| 画面写真・動画・ビルド | その文がどの画面のどこに出るか | 短い言葉ほど、文脈なしでは訳せない |
| 記法の説明 | {name} などの変数、改行や色の記号の意味 | 変数を訳したり消したりする事故を防ぐ |
依頼先には、翻訳会社・個人の翻訳者・ファンの有志などがあります。文章の多い作品ほど、最初に少量を試しに訳してもらい、質と進め方を確かめてから全体を頼むと安心です。
訳文は、翻訳した人の著作物(二次的著作物)になりえます(著作権法第2条第1項第11号)。権利の扱い(譲渡か利用の許諾か)とクレジットは契約で決めます。ゲームを売る事業として、従業員のいない個人の翻訳者に発注するなら、取引条件を書面やメールで明示します(フリーランス・事業者間取引適正化等法 第3条。公正取引委員会)。法的な助言ではないので、最終確認は公式の資料や専門家で行ってください(詳しくは「ゲーム開発の権利と規約」)。
LQA(実機での翻訳チェック)
ひとことで:その言語のネイティブが、実際のゲーム画面で訳文を確かめる工程です。
IGDA(国際ゲーム開発者協会)の解説では、LQA(Linguistic/Localization Quality Assurance)は「その言語のネイティブが、訳文をゲームの中の文脈で確かめること」で、翻訳・編集・校正とは別の工程として、その後に行います(How to Get the Most from LQA)。翻訳ファイルの上では正しくても、画面に出すと意味が通らない・はみ出す・字形が違う、ということが起きるからです。
| 見る点 | 例 |
|---|---|
| はみ出し・切れ | ボタンの文字が枠から出る、行の途中で切れる |
| 文脈の誤り | 戻るボタンの「Back」を「背中」と訳した、話し手と口調が合わない |
| 用語のぶれ | 同じアイテムの名前が画面ごとに違う |
| 変数と記号 | {name} がそのまま出る、語順がおかしい |
| 未翻訳 | 原文の言語のまま残っている |
| フォント | 豆腐(□)、繁体字の画面に簡体字の字形 |
| 音声と字幕 | 字幕の表示時間が短い、声と字幕の内容が違う |
進め方は、全画面を巡る手順を作って言語ごとに同じ手順で見る、問題は「言語・画面・キー・スクリーンショット・直した訳の案」をそろえて報告してもらう、直したら同じ画面をもう一度見る、の3つが基本です。
 夕宮たいだ
翻訳ファイルだけ見て「訳せた!」で出すのは絶対ダメだよ! 画面に出したら切れてた、ってことがよくあるんだぁ。
ストアページの翻訳と対応言語の表示
ひとことで:Steam では言語ごとに「インターフェース」「フル音声」「字幕」を表示し、対応しているかはゲーム内の言語設定で判断されます。
2026年10月時点の Steamworks の公式ドキュメント(Localization and Languages)によると、次のとおりです。
- 対応言語は、言語ごとに「インターフェース(メニューや UI)」「フル音声」「字幕」を指定して表示する
- 対応しているかどうかは、ストアページではなく、ゲーム内の言語設定で判断される。説明文だけを訳した言語は、対応言語として載せない
- ストアページの説明文・画像・トレーラーも、言語ごとに入れられる
- ゲームは ISteamApps::GetCurrentGameLanguage で、利用者がそのゲームに選んだ言語を受け取れる。選んでいなければ Steam の表示言語が返る(ISteamApps)。初回の起動時の言語に使うと、利用者が言語を探さずに済む
期間限定でカプセル画像に文字を入れる Artwork Override を使うときは、その文字をゲームの対応言語すべてに翻訳します(Graphical Asset Rules)。作品名の欄にも注意が要ります。筆者の麻雀ゲームは、初回のストアページの審査で「日本語の作品名が既定の欄にしか入っていない」と差し戻され、英語の作品名を既定の欄、日本語の作品名を日本語の欄に入れ直して通過しました。Steam では英語が既定の予備の言語なので、既定の欄は英語で埋めておくのが無難です。
ローカライズの完了の条件
ひとことで:宣言する言語ごとに、未翻訳0・はみ出し0・LQA の指摘の修正済みを確かめたら完了です。
- ストアで対応を宣言する言語で、未翻訳の文字列が0件(テストで確かめる)
- 全画面で、はみ出し・豆腐・字形の誤りがない
- LQA の指摘がすべて直り、直した画面をもう一度確認した
- ストアページの説明文・画像・対応言語の表示が、ゲームの中身と一致している
- 発売後の更新で訳を足す手順(誰が、いつ、どの言語を)が決まっている
AIゲーム開発でのローカライズ
ひとことで:一次訳と検査は AI に任せやすく、どの言語に出すか・言葉の雰囲気・最終の品質は人が決めます。校正を通さずに出すことはしません。
翻訳は速くなるが、確かめる量は減らない
LLM(大規模言語モデル。文章を扱う AI)を使うと、一次訳は短い時間で、複数の言語を同時に作れます。一方で、AI の訳は文脈を取り違えたり、用語がぶれたり、変数や記号を壊したりすることがあります。工程の重心は「訳す」から「確かめる仕組みを作り、ネイティブ(人または別の AI)が校正する」へ移ります。
| AI に任せやすいこと | 人が決めること・確かめること |
|---|---|
| コードに直接書かれた文字列を洗い出し、翻訳ファイルへ移す | どの言語に出すか(費用と、発売後も直し続けられるか) |
| 言語ごと・ファイルごとに分けた一次訳を並列で作る | 作品の言葉の雰囲気、キャラの口調、固有名詞の訳 |
| 用語集どおりか・変数の欠け・文字数の上限超えを自動で検査する | 校正者の手配と、最終の品質の判断 |
| 未翻訳を数え、宣言する言語に1件でもあればテストを失敗させる | 画面のはみ出しを見て、どう直すか |
AI で訳した文章はプレイヤーが触れる内容なので、2026年10月時点の Steam の公式ドキュメントでは、AI 生成コンテンツの開示の対象です(申告の例にもローカライズが入っています。Content Survey)。
筆者の麻雀ゲームの「差分一括方式」
筆者の「つみこめ!イカサマ魔法麻雀」は、次の方式で7言語に対応しています。
- 開発は日本語だけで進め、翻訳した時点の控えと今の日本語を比べて、増えた・変わった文字列を自動で一覧にする
- 節目ごとに、その差分だけをまとめて翻訳する
- まだ訳していない文字列は、英語 → 日本語の順で代わりに表示する(開発中もゲームが止まらない)
- ストアで対応を宣言する言語は、「未翻訳0」をテストが関所として確かめる
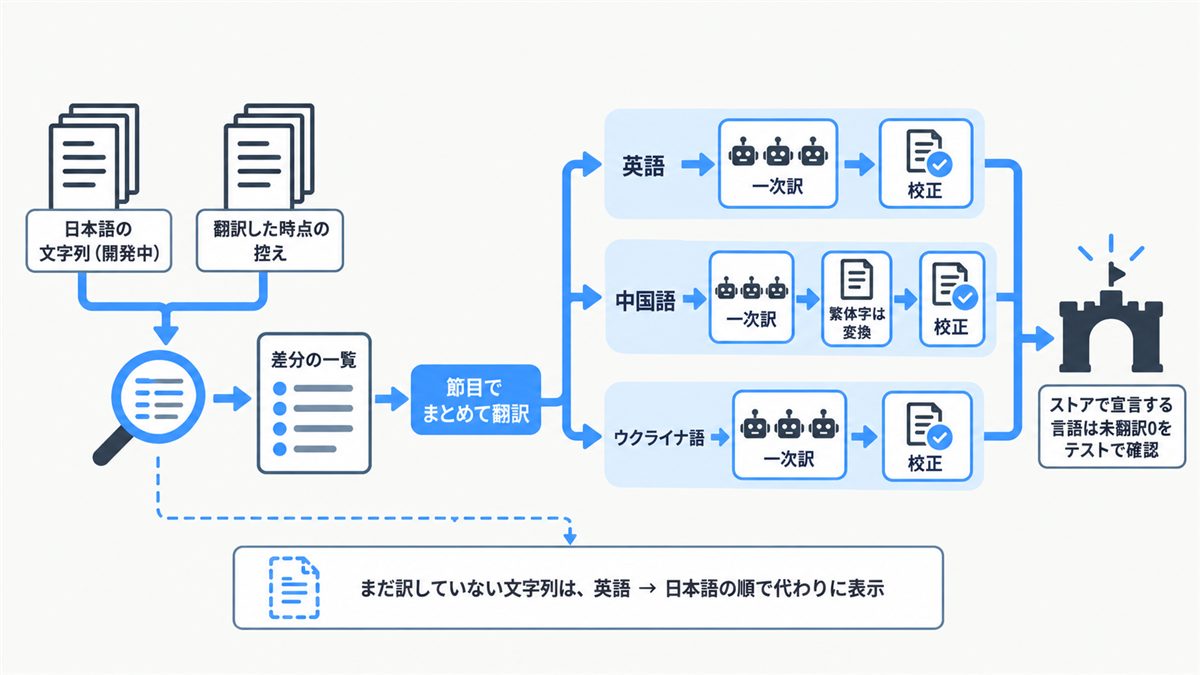
分業は次のとおりです。
- 英語:LLM の一次訳 → Codex が校正(2,625行と32ファイルを見て379行を修正)
- 中国語:LLM を14並列で動かして一次訳 → 繁体字は変換ツールの OpenCC で作る → Codex が校正
- ウクライナ語:Claude を15並列で動かして一次訳 → Codex が校正(校正者が競技団体の表記を調べ、用語の訳を一括で変更)
OpenCC は中国本土・台湾・香港の言い回しの違いに合わせた変換の設定も持っていますが(OpenCC)、変換だけで地域の言葉づかいが合うとは限らないので、校正を通します。発売後に翻訳の緊急の修正が要るときは、英語だけを同時に訳し、ほかの言語は次の節目でまとめて訳しています。
AI 翻訳の落とし穴
- 豆腐:AI は訳文を作れても、その文字がフォントにあるかは訳文を見ただけではわかりません。筆者のブラウザ版のゲームでは、Web では OS のフォントで補えないため ▶ ✓ ⚠ などの記号が豆腐になりました。予備のフォントをつなぎ、書き出しのときに字形の有無を検査して止めるようにしています
- 言語の切り替えの不具合:筆者の麻雀ゲームには、通常の起動のときだけ表示が日本語に固定されるバグがありました。起動時の引数で言語を指定すると再現しないので、テストでは初回の起動・設定の読み込み・Steam から渡される言語の経路を、それぞれ通常の起動で確かめます
- プラットフォームの決まり:動画サイト内で遊べるミニゲーム版では、ブラウザの言語設定を読み取ること自体が禁止だったので、書き出した後に読み取りの箇所を消し、テストで検査しました
- 変数と用語:AI は
{name}を訳したり、改行の記号を消したりすることがあります。用語集を依頼文で渡すだけでなく、守られたかをスクリプトで検査します
並列の進め方は「Claude Code サブエージェント・並列作業ガイド」、依頼文の組み立て方は「Claude Code プロンプト設計」で解説しています。
Goal: 前回の翻訳以降に増えた・変わった日本語の文字列だけを、英語に一次訳する
Context: 原文は locale/ja.csv、前回翻訳時の控えは locale/snapshot/ja.csv。用語集は docs/glossary.csv で、必ず従う。
話し手と表示場所は docs/context.csv。{name} などの変数と改行の記号は訳さずに残す
Done when: 差分の行だけが locale/en.csv に入り、用語集とのずれ・変数の欠け・文字数の上限超えを調べる
スクリプトが0件を返す。判断に迷った訳は一覧にして残してある 夕宮たいだ
差分だけ訳して、未翻訳はテストで止める。これなら日本語で作りながらでも、言語を増やしていけるでしょ?
よくある失敗と対処
ひとことで:多くは「後から国際化した」「文脈を渡さなかった」「画面で確かめなかった」のどれかです。
| 失敗 | 原因 | 対処 |
|---|---|---|
| 言語を足すたびに画面を作り直す | 文字列や文字入りの画像が、コードや素材に直接入っている | 文字列を翻訳ファイルに出し、文字は画像と分ける |
| 訳文が画面からはみ出す | 原文の長さで枠を決めた | 余裕を持たせ、疑似ローカライズで先に確かめる |
| 語順がおかしい | 文章を部品に分けてつないでいる | 1文のまま渡し、名前付きの変数を使う |
| 文字が豆腐(□)になる | フォントにその言語の文字がない | 言語ごとのフォントを用意し、字形を検査する |
| 用語やキャラの口調がばらばら | 用語集とスタイルガイドがない | 翻訳の前に作って渡し、検査する |
| 宣言した言語に未翻訳が残る | 発売前の追加分を訳し忘れた | 未翻訳0をテストの条件にする |
チェックリスト
ひとことで:言語を足す前と出す前に、次の項目を確かめます。
- [ ] 画面に出る文字列を、すべて翻訳ファイルに出した
- [ ] 文章をつながず、名前付きの変数と複数形の仕組みを使っている
- [ ] 疑似ローカライズで、はみ出しと未対応の文字列を探した
- [ ] 対応する言語の文字が、すべてフォントにある
- [ ] どの言語に出すかを、調べた月つきのデータと作品の相性で決めた
- [ ] 用語集・スタイルガイド・文脈のメモ・画面写真を翻訳者に渡した
- [ ] ネイティブ(人または別の AI)の校正と、実機での LQA を通した
- [ ] ストアで宣言する言語の未翻訳が0件であることを、テストで確かめた
- [ ] ストアページの対応言語の表示が、実際と一致している
- [ ] AI で訳した場合は、Steam の開示に書いた
次に読む記事
ひとことで:ローカライズの後に続く工程の記事です。
- βROM(ベータ版)とは:素材がそろった後の確認と仕上げ
- Steamストアページの作り方:対応言語・説明文・画像の入れ方
- ゲーム開発の権利と規約:フォントのライセンスと AI の開示
- ゲームのデバッグとQA:バグ報告と修正の確認
- ゲーム開発の全工程マップ:ローカライズが全体のどこにあるか
夕宮たいだふぁ……文字列を外に出して、フォントをそろえて、ネイティブに確かめてもらう。これで多言語対応の土台はできた……かなぁ。まずは疑似ローカライズで、画面が崩れないか見てみてねぇ。